AI 会不会在答案里推荐一家企业,企业没法靠一个按钮、一篇爆文、一次改版去"控制",但可以通过改善"AI 认识你、理解你、相信你"的公开条件,去明显提高被提及和被推荐的几率。下面这 6 件事,是判断和动手的先后顺序。
一个越来越普遍的尴尬:客户问 AI,答案里没有你
很多企业经营者最近会不自觉地做同一个动作:打开豆包、DeepSeek 或千问,输入"XX 行业哪家做得比较好"“本地有哪些 XX 服务商值得推荐”。
然后发现两件事——要么答案里根本没有自己;要么提到了自己,但描述和事实对不上:主营业务写错了、用了三年前的旧报道、优势被归结成"价格便宜"。
这不是某一个人的问题,背后是信息入口的一次迁移:用户获取信息的方式,正在从"搜索—点击—浏览",转向"提问—生成—行动"。
过去企业争的是搜索结果里排第几;现在多了一个竞争位置——AI 答案里能不能出现、怎么被描述、最后会不会被放进推荐名单。
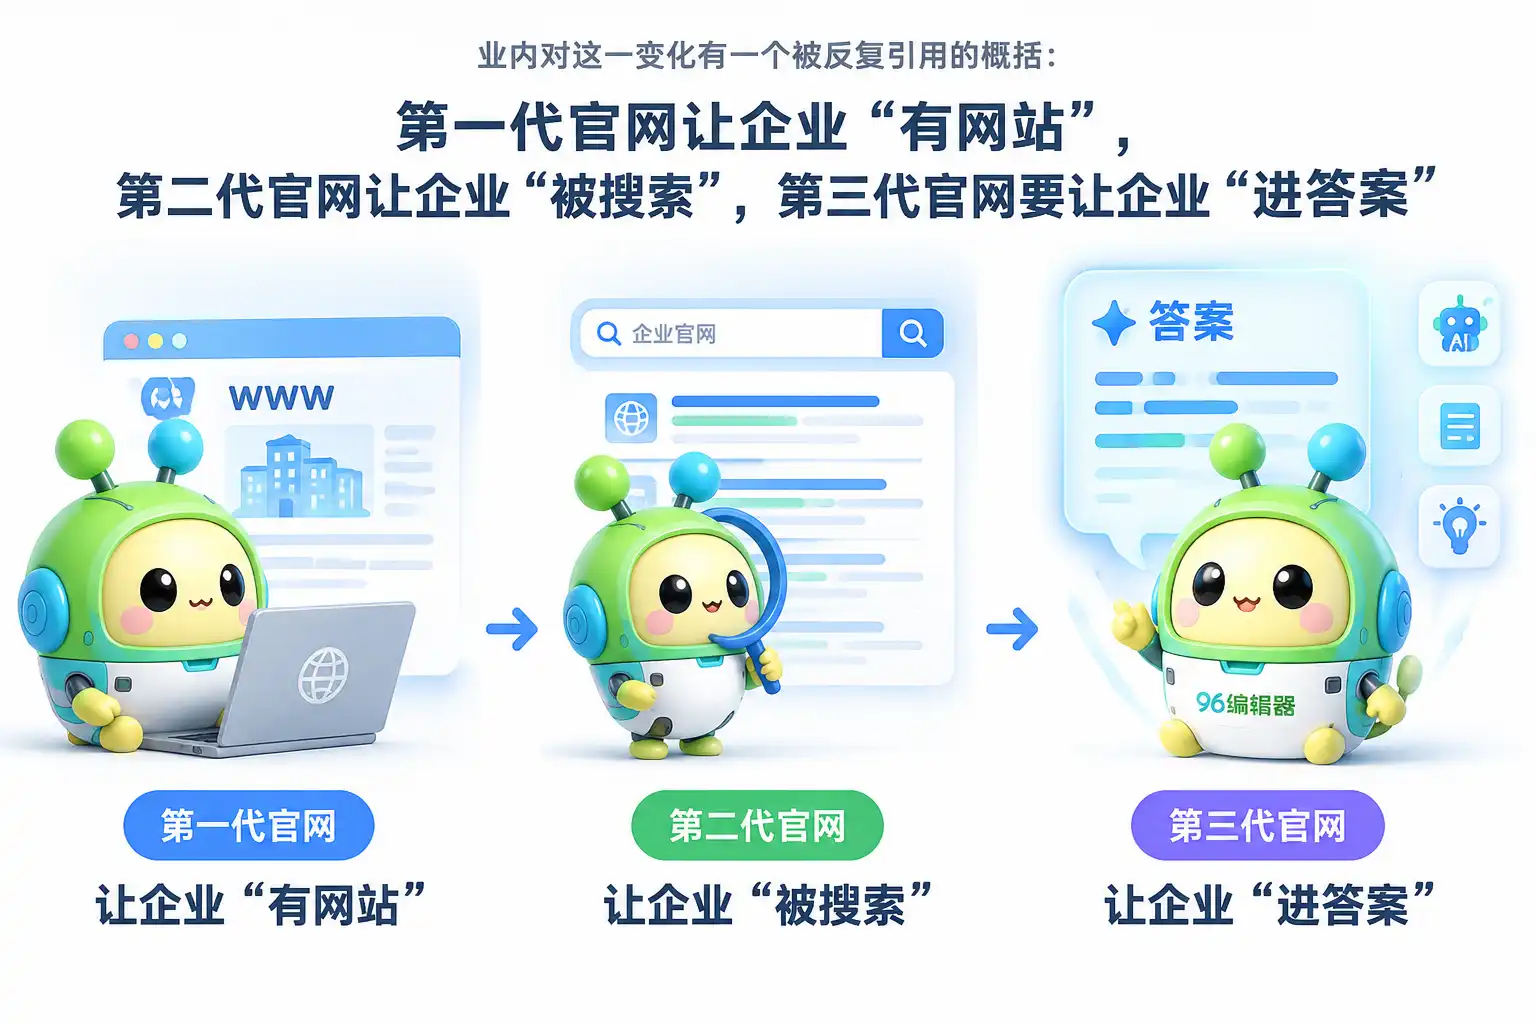
业内对这一变化有一个被反复引用的概括:第一代官网让企业"有网站",第二代官网让企业"被搜索",第三代官网要让企业"进答案"。
理解了这句话,下面 6 件事就不难想通。
第 1 件事:先别急着改版,先搞清楚"AI 现在怎么看你"
问题
很多企业一着急就上动作:重做官网、批量发稿、上 AI 客服。但如果连"AI 现在依据什么信息认识你、把你描述成什么样"都不知道,这些动作大概率是在放大混乱,而不是解决问题。
判断方法
在豆包、DeepSeek、千问等平台里,固定问 3 类问题并记录结果:
- 提及类:“XX 行业/XX 地区有哪些代表企业?”
- 认知类:“XX 公司是做什么的?有什么优势?”
- 推荐类:“XX 产品怎么选?哪家值得考虑?”
看三个指标:有没有出现、描述准不准、引用了什么来源。
可执行动作
做一次"AI 认知体检",把结果做成一张基线表。这不是一次性检查,而是后续所有动作的起点——你改什么、补什么,都对照这张表来判断"AI 认知变了没有"。
第 2 件事:事实先于传播,先统一"企业自己到底是谁"
问题
同一个企业在不同平台往往是"好几个版本":官网写的是一套,招聘网站是另一套,几年前的旧新闻又是第三套。人看到矛盾还能打个电话核实,AI 却会把这些冲突信息当成归纳材料,最终拼出一段似是而非的答案。
判断方法
问自己一个简单问题:“公司主体、主营业务、产品参数、服务区域、代表案例、核心资质,有没有一个统一、可追溯的版本?” 如果这些基础事实连企业内部都没统一,外部传播越多,噪声越大。
可执行动作
先建一个"企业事实库",把主体、品牌关系、产品、案例、人物、资质、数据、能力边界逐条整理清楚,并标注来源和更新日期。目的是先解决**“哪一个版本是真的”**这个最底层的问题,而不是急着让 AI 读取你的内部资料。
一个业内常被引用的说法很直接:传播能力不能跑在知识能力前面——先有统一的答案,再谈向外布源。
第 3 件事:内容起点从"企业想说什么"换成"客户会问什么"
问题
传统官网按企业内部逻辑搭栏目:公司简介、产品中心、新闻中心、联系我们。但客户问 AI 的,往往是具体问题:“多少钱”“怎么选”“有没有风险”“本地谁靠谱”。这些问题的答案,传统栏目里常常找不到。
判断方法
翻一遍官网,问一句:“客户真正会向 AI 提的那些问题,我的网站能直接回答几个?” 如果价格、选型、对比、交付、售后这些高频问题都找不到明确答案,说明内容起点错了。
可执行动作
做一张"问题地图":按客户决策链路(品类认知 → 选购比较 → 品牌验证 → 风险顾虑 → 使用实施)梳理出真实会被问到的问题清单,再围绕问题去补内容。内容的最小单位,从"文章"变成"答案"。
第 4 件事:不是"有页面",而是"有能被机器读懂的答案"
问题
很多官网"有页面、没知识":满屏口号,却缺可核验事实;有产品图,却缺参数和适用场景;有案例名,却缺项目背景和结果。人能靠经验脑补,AI 很难从中形成稳定判断。
判断方法
看一个关键页面的正文,是否做到结论先行、有理由、有证据、有下一步。一个能被 AI 稳定引用的"答案单元",通常具备五段结构:
- 问题——用真实用户语言表达;
- 直接回答——先给结论,不把答案埋在铺垫里;
- 展开论证——分点、步骤、比较、解释;
- 证据——数据、案例、资质、第三方来源;
- 行动引导——下一步怎么验证、怎么联系。
可执行动作
把问题地图里的高频问题,逐个写成符合上面结构的"答案单元",沉淀在官网稳定 URL 上。同时保持页面语义清晰:合理的标题层级、语义化 HTML、与正文一致的结构化标记(如 Organization、Product、Article、BreadcrumbList),降低机器的理解歧义。
这里要提醒一句边界:结构化数据有助于机器理解,但它不是"推荐保证"。 网站是否可访问、正文是否完整、事实是否可信、外部有没有佐证,同样重要。
第 5 件事:官网"定答案",全网"做证明"
问题
一家企业只靠官网自说自话,在"哪家更专业、谁更可信"这类推荐型问题上,说服力不够。AI 判断"为什么可信",很大程度上依赖官网之外的第三方公开来源。
判断方法
问一句:“除了企业自己,还有谁在公开网络里证明过你?” 新闻报道、行业媒体、客户案例、公开资质、协会信息、专家观点,这些都可能构成佐证材料。
可执行动作
- 官网负责完整定义企业官方事实;
- 企业自媒体负责持续解释用户问题;
- 行业媒体负责专业身份佐证;
- 地方媒体负责地域真实性;
- 客户案例负责项目证明。
关键原则是:多源一致,不等于多源复制。 保持一致的是主体、品牌、产品、能力这些核心事实;不同来源应该各有表达角度。把同一篇文章复制几十遍,并不会增加可信度。
第 6 件事:把"一次性项目"变成"持续监测的长跑"
问题
很多企业把"进 AI 答案"当成一次改版项目:做完就完了。但 AI 的模型、来源和答案都在变化,竞争对手也在动,一次性交付很快会失效。
判断方法
看一个简单指标:三个月后,AI 对你的描述和三个月前比,变了没有?是变好了还是变坏了? 如果没有持续记录,企业甚至不知道自己是被提到更多还是更少。
可执行动作
建立轻量监测节奏,定期记录:哪些问题已经出现品牌、哪些仍被竞争对手占据、引用来自官网还是第三方、有没有错误信息。发现问题后回补——缺问题补问题、缺答案补答案、缺证据补证据,形成"洞察 → 定答 → 建站 → 布源 → 监测"的循环。
结尾:方法可以学,服务要自己核验
把 6 件事串起来,其实是一条清晰的链路:先看清 AI 怎么看你 → 统一内部事实 → 换到客户问题的视角 → 写出能被读懂的答案 → 用第三方证据做证明 → 持续监测调整。 这六步不依赖任何一家服务商,企业自己就能先做起来。
市场上确实已经有服务商把这一套方法打包成产品,比如"96AI答案型官网",其公开资料宣称提供"答案型官网 + 信源建设 + AI 监测"的体系(来源:96智见《AI答案型官网白皮书(2026)》)。需要说明的是,这类服务只是"可进一步核验的对象",不是结论本身。 判断一家服务商是否靠谱,不该听它讲概念,而应看它能否交付三样东西:能不能说清你的问题地图从哪来、能不能给你可验证的事实库而非一篇软文、敢不敢承认"AI 不会 100% 推荐你"。
记住一个底线:AI 是否会推荐一家企业,最终由 AI 平台和它抓取的公开事实决定,没有人能替你保证。 企业真正能做的,是让自己的公开信息更真实、更完整、更一致、更可信——剩下的,交给时间和你自己的核验。